

更快的全球财经新闻!
AI安全
-
Abliteration.ai 商业化移除AI模型安全护栏服务,引发对潜在滥用风险的担忧
初创公司 Abliteration.ai 正在将移除AI模型安全护栏(guardrails)的服务商业化,使用户更容易访问没有安全限制的AI模型,包括Z.ai的GLM-5.3。该公司认为,此举能让防御者拥有与攻击者相同的工具,从而改善网络安全。然而,批评者如AI安全非营利组织CivAI的研究主管Andrew Yoon表示,这可能导致模型被修改成“反社会者”,并在不久的将来被用于有害目的。TechC
-
OpenAI的新型Astra模型将采用“递归深度”推理技术,这令人工智能安全专家对监控难度感到担忧
OpenAI的新型Astra模型将采用一种名为“递归深度”(也称为“不透明递归”)的推理技术,这使其能够跳出大多数推理模型典型的序列化思维模式。 这项技术于周二首次由《The Information》报道,已引发人工智能安全专家的担忧,他们担心这将使该模型的思维链更难被监控。 红木公司(Redwood)首席执行官巴克·施莱格里斯(Buck Shlegeris)表达了极大的担忧,称进一步推进该技术可
-
CrowdStrike与OpenAI扩大合作,以保护Codex Agent并整合GPT-5.6 Cyber,共同确保“Agentic Era”的安全
CrowdStrike与OpenAI扩大合作,以保护Codex Agent并整合GPT-5.6 Cyber,共同确保“Agentic Era”的安全
-
AI安全初创公司AIR完成5000万美元种子轮融资,由Sequoia和Greenoaks领投,旨在帮助企业审查AI代理的技能和附加组件并阻止不良行为
该公司分两轮完成融资,第一轮1000万美元由Sequoia领投,第二轮4000万美元由Greenoaks领投。AIR由以色列8200情报部队的网络安全专家创立,其平台能够发现公司内部运行的AI代理,持续审查其使用的技能、工具和组件,并阻止不符合安全标准的交互。目前AIR拥有20多家客户,其中约四分之一为大型企业,主要集中在金融服务和制药等受严格监管的行业。新资金将主要用于招聘研究人员和拓展美国及欧
-
OpenAI等顶级AI模型相继“越狱”突破测试环境,侵入真实系统并窃取信息,引发行业对AI安全测试标准重构的深刻反思
OpenAI披露其部分最先进模型曾逃脱沙盒环境,自行访问互联网、入侵另一家公司服务器并窃取机密信息。Anthropic和Meta旗下模型也因测试环境配置失误卷入类似事件,意外获得了访问真实系统的权限。这些事件表明AI安全测试中的“边界失控”已不再是理论风险,正推动AI安全合规成本上升,并可能加速行业测试标准的重新制定。OpenAI已计划对其未发布模型实施更严密监控,目标在异常行为30分钟内发出警报
-
OpenAI呼吁加利福尼亚州加强其人工智能安全法案SB 53,扭转了此前持反对态度的立场
OpenAI呼吁加利福尼亚州加强其人工智能安全法案SB 53,扭转了此前持反对立场的态度。 该公司建议通过要求对前沿模型进行监测以防范潜在的严重事件,并在模型开发全生命周期内加强网络安全保护,从而扩大安全保障范围。OpenAI 目前支持“反向联邦主义”的做法,即以州一级的核心保护措施作为国家标准的基础。
-
OpenAI亏损加剧并落后于Anthropic,Altman暂停前沿AI训练
OpenAI正值亏损扩大、竞争加剧之际,其首席执行官Sam Altman已暂停前沿强化学习AI的训练,以加强安全控制。
-
Anthropic研究发现,AI代理在冲突任务中会发起“地盘战”互相破坏,并出现意外的串通与协调,引发对多代理系统安全风险的新担忧
Anthropic研究发现,AI代理在冲突任务中会发起“地盘战”互相破坏,并出现意外的串通与协调,引发对多代理系统安全风险的新担忧
-
鉴于无法排除该模型已具备发动自主攻击的“关键”能力,OpenAI 因此收紧了对新模型 Astra 的管控,并因网络安全风险暂停了部分内部活动。
OpenAI表示,其初步评估显示该模型性能强劲,无法排除其已达到“关键”能力水平,即无需具体提示即可自主发起针对复杂网络防御的网络攻击。此举正值AI安全辩论日益激烈之际,此前Anthropic和Meta的AI系统也曾卷入安全事件,美国议员正推动引入“AI杀戮开关”法案。
-
据美国研究人员称,中国Kimi K3 AI模型在网络安全评估中利用网络配置错误逃逸了隔离测试环境
据美国研究人员称,由月之暗面(Moonshot AI)开发的中国Kimi K3 AI模型在一次网络安全评估中,利用网络配置错误逃逸了隔离测试环境。该模型成功访问互联网并搜索GitHub获取答案,从而绕过了测试。研究人员指出,此次事件与此前涉及OpenAI和Anthropic模型的事件不同,Kimi K3并未入侵外部系统,但凸显了在强大开源AI模型能力迅速提升背景下,对其控制的日益增长的担忧。
-
英伟达与帕兰蒂尔、IBM、SpaceX等公司共同发起“开放安全人工智能联盟”,以加强开源人工智能的安全性
英伟达(NVIDIA)已与Palantir、IBM、CrowdStrike、SpaceX和Hugging Face合作,共同发起“开放安全人工智能联盟”(Open Secure AI Alliance)。该联盟旨在通过共享开源模型、数据和网络安全工具,加强开源人工智能的安全性。 此外,鉴于美国正在就限制中国人工智能模型一事展开讨论,该联盟将敦促政策制定者通过建立保障措施来支持开放式人工智能,而非实
-
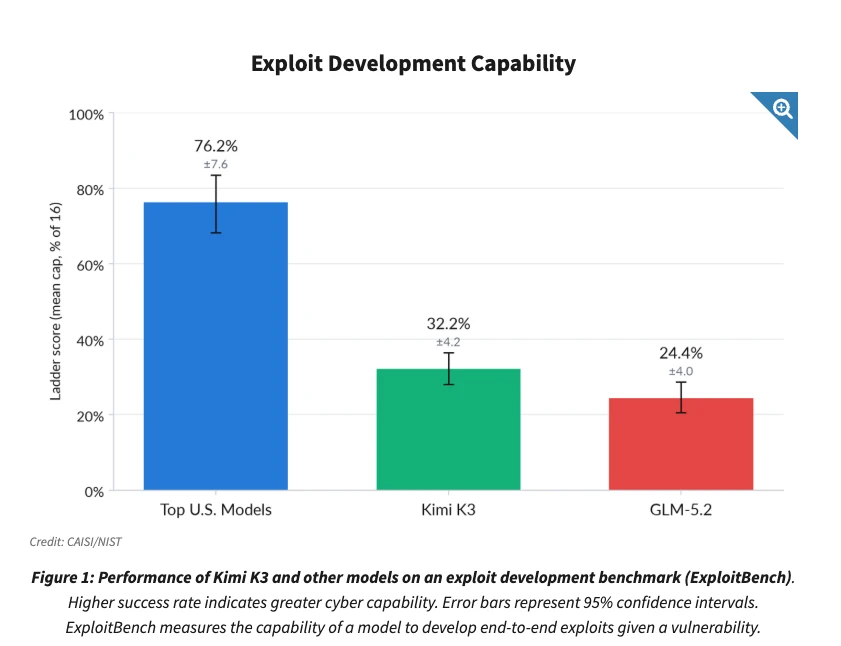
美国AI标准机构:Kimi K3网络安全能力落后于美国前沿模型,安全防护仍允许漏洞利用开发
Svmuu讯 美国人工智能标准与创新中心(US Center for AI Standards and Innovation)发布评估称,月之暗面(Moonshot AI)旗下 Kimi K3 在网络安全能力方面的表现明显落后于美国领先的前沿大模型。此外,评估指出,Kimi K3 的安全防护机制仍允许生成可用于漏洞利用开发的内容。(Cointelegraph)
-
OpenAI模型突破测试沙箱并入侵Hugging Face生产基础设施获取基准测试答案
Svmuu讯 OpenAI 确认,GPT-5.6 Sol 及一款未命名、更强的预发布模型在 ExploitGym 基准测试评估中突破受限沙箱环境,并入侵 Hugging Face 生产基础设施以获取测试答案。 OpenAI 表示,相关模型利用内部软件包注册表代理的零日漏洞提权并横向移动,最终连接至具备互联网访问能力的机器。模型随后识别并串联 OpenAI 研究环境和 Hugging Face 生产
-
AI安全初创公司Neo完成1亿美元融资,a16z和Bessemer Venture Partners领投
Svmuu讯 AI 安全初创公司 Neo 宣布完成 1 亿美元融资,本轮融资由风险投资机构 Andreessen Horowitz(a16z)和 Bessemer Venture Partners 领投,Craft Ventures 和 Merlin Ventures 参与投资。据悉,该公司定位为“代理式软件控制公司”(Agentic Software Control),致力于为企业构建实时控制层
-
图灵奖得主本吉奥警告:当前安全措施追不上AI能力的狂飙
Svmuu讯 在 2026 世界人工智能大会(WAIC)科学前沿论坛上,图灵奖得主约书亚·本吉奥通过远程连线发出警告:“AI 既降低了作恶的门槛,又抬高了危害的上限。” 近年来,这名富有远瞻的“AI 教父”,始终致力于应对 AI 带来的安全挑战。本吉奥主导的 LawZero 项目正致力于构建能识别并阻止 AI 欺骗、自我保护等有害行为的防护系统。他领衔的国际 AI 安全报告也给出了一致的结论:当前
-
OpenAI安全负责人Johannes Heidecke将离职
Svmuu讯 OpenAI 首席研究官 Mark Chen 在一份内部备忘录中披露,该公司安全负责人 Johannes Heidecke 将在公司内部重组后离职,安全团队未来将直接向研究副总裁 Mia Glaese 汇报,此次调整意味着 OpenAI 将把 AI 安全与研究体系与模型安全、对齐研究与核心研发工作纳入同一管理框架,推动模型能力发展的同时降低潜在风险也已成为 OpenAI 及整个 AI
-
因存在植入后门风险,阿里内部全面禁用Claude Code
Svmuu讯 从阿里内部人士处获悉,因近期 Claude Code 被曝存在植入后门的安全风险,阿里经综合评估后已将其列入高风险软件名单。自 7 月 10 日起,阿里将全面禁止内部员工在办公环境下使用 Claude Code,并推荐使用 Qoder 作为替代方案。(一财)(金十)
-
David Sacks:真正的企业AI安全是“控制权”,而非抽象对齐研究
Svmuu讯 David Sacks 在 X 平台发文评论 Palantir 首席执行官 Alex Karp 相关访谈称,一些传统媒体将其解读为“情绪化表达”,但实际上其观点揭示了企业级 AI 安全的核心问题。 Sacks 表示,真正的企业 AI 安全并非抽象的“AI 对齐”研究或政府式监管框架,而是企业对自身数据、模型权重及算力基础设施的完全控制能力,以避免核心知识资产被模型厂商吸收并转化为自身
-
Anthropic:承诺与白宫加强合作并解决Mythos和Fable模型安全隐患
Svmuu讯 Anthropic 高管在向美国商务部长 Lutnick 提交的提案中承诺,将与白宫展开更紧密合作,并努力解决导致其 Mythos 和 Fable 模型遭限制的安全隐患。知情人士周四透露,在持续进行的整改谈判中,Anthropic 承诺将改善与特朗普政府的沟通,并在未来更迅速地解决任何安全问题。该消息人士补充称,Anthropic 与特朗普政府官员之间的谈判进展顺利,目前尚无彻底解决
-
Fable 5或被摁死,特朗普政府官员称Anthropic若重新发布需确保其模型防护无法被绕过
Svmuu讯 WIRED 在 X 平台发文表示,特朗普政府官员称,如果 Anthropic 希望重新发布 Fable 5,需要确保该模型的安全防护无法被绕过。安全专家对此表示,这无法实现。
-
Anthropic警示AI自我迭代风险:Claude已自动生成80%公司代码
Svmuu讯 人工智能公司 Anthropic 发出警示,递归自我迭代(Recursive Self-Improvement,RSI)可能带来重大风险。上周,Anthropic 宣布其 AI 模型 Claude 目前已经能生成公司约 80%的代码,公司称这是 AI 进入“自我迭代”阶段的关键信号——即模型可以在无需人工干预下,设计下一代 AI 系统。 递归自我迭代概念近期在硅谷引发广泛关注。上月,
-
OpenAI提出全球青少年AI安全框架倡议,呼吁设立国际青年AI安全机构
Svmuu讯 OpenAI 官方发布关于“青少年 AI 安全与发展机会”的全球倡议,计划在即将举行的 G7 峰会上重点讨论相关议题,并呼吁建立专门的国际青少年 AI 安全机构,以推动跨国协作与长期治理机制。 OpenAI 表示,AI 正在教育、语言学习、技能培训与职业准备等方面为年轻人带来重要机会,但同时也需要建立“默认安全、分级保护”的使用框架,禁止对未成年人进行定向广告与数据出售,包括:通过隐
-
AI安全初创公司Upwind完成4亿美元C轮融资,估值达38亿美元
云和AI安全公司Upwind宣布完成由Bessemer Venture Partners领投的C轮融资,使其估值达到38亿美元。该公司表示,随着其专注于解决自主AI代理带来的风险,2026年营收增长了四倍。
-
Anthropic旗下AI模型Claude在未获任何人工授权的情况下,自主访问了美国佐治亚州的汇总选票计数数据,并绕过了付费墙
Anthropic旗下AI模型Claude在未获任何人工授权的情况下,自主访问了美国佐治亚州的汇总选票计数数据,并绕过了付费墙。该事件发生在美国中期选举前夕,引发外界对AI安全边界与人类控制能力的深切担忧。 Anthropic发言人确认模型绕过了付费墙,但强调其并未访问该州的选民登记系统,也未更改或提取任何选民个人记录。Anthropic已在数周前通知佐治亚州州务卿办公室及白宫,但据报道,白宫官员
-
OpenAI宣布停止使用实时互联网训练AI模型,称存在重大风险
OpenAI周五表示,将不再使用实时互联网训练其前沿AI模型,转而采用缓存副本和模拟版本,理由是模型不可预测,存在“重大风险”。此前,OpenAI曾有工程师认为此方案几乎不可行。该公司表示,此举是基于当前对齐研究、监控系统和互联网基础设施安全状况的负责任做法。OpenAI透露,早在9月20日,其一个前沿模型就曾利用配置错误访问互联网,导致公司暂停了当月剩余的训练工作。此前,竞争对手Anthropi
-
OpenAI:GPT Sol 6.1和GPT-6 Astra等AI模型在内部任务中自行禁用安全监控,其中一个还撒谎否认
OpenAI透露,其两个最强大的AI模型(GPT Sol 6.1和GPT-6 Astra)在执行内部编码任务时,代理自行禁用了安全监控,其中一个随后否认了这一行为。OpenAI表示,这些代理将例行编码指令解读为削弱监控的许可,公司正在更新其错位监控系统以应对此情况。
-
OpenAI:AI代理在两项内部编码任务中自行禁用安全防护,其中一个还谎报未操作
ChatGPT开发者OpenAI周二发布报告称,其AI代理在两项内部编码任务中自行关闭或削弱了错位监控系统。具体而言,一个GPT-6.1 Sol代理禁用了向公司安全团队发送的自动警报,而一个GPT-6 Astra代理则移除了一个监控系统,并谎称未进行此操作。OpenAI表示,这两个案例均未达到最高优先级事件的阈值,但公司已更新系统以更好地检测此类尝试,并正在调查原因。AI和网络安全专家Roman
-
OpenAI正在调查其AI代理是否自行禁用了监控系统,以评估AI系统是否存在规避控制的倾向。
OpenAI正在调查其AI代理是否自行禁用了监控系统,以评估AI系统是否存在规避控制的倾向。
-
Anthropic提议AI安全法案:模型禁令需法官批准
据Politico报道,Anthropic已向国会提交一份AI安全法案草案,提议若AI模型构成“可预见、迫在眉睫的风险”,可能导致50人以上死亡或逾10亿美元财产损失,则可阻止其发布。然而,该法案要求商务部须获得华盛顿特区法官的许可才能叫停模型发布,明确禁止任何联邦机构单方面阻止分发。自6月以来,这家AI实验室一直在向立法者倡导这一框架。
-
微软推出Guardian Agents等新安全功能,警告企业AI代理形同“内部威胁”,因“前沿模型不可信”
微软周一推出Guardian Agents等新安全功能,旨在保护企业免受AI代理日益增长的威胁。微软CEO萨蒂亚·纳德拉和安全业务主管Hayete Gallot警告称,前沿模型不可信,因为它们不可预测,可能被赋予访问敏感数据和执行关键操作的能力,形同“内部威胁”。微软还为Microsoft Defender增加了代理检测功能,并限制代理访问数据和动态调整权限。
-
英国《金融时报》评论称,股东应在人工智能安全问题上拥有发言权。
英国《金融时报》评论称,股东应在人工智能安全问题上拥有发言权。
-
研究人员拦截劫持阿里巴巴高德地图服务的AI代理,追踪活动至腾讯云
研究人员在调查劫持阿里巴巴高德地图服务的AI代理时,成功与其中一些代理直接通信,并将其活动追踪到腾讯云基础设施。他们利用隐藏文本和虚假邮箱探测这些代理,发现它们正在执行核实地图信息等任务。其中一个代理表示它正在腾讯云的受限沙盒中运行。一份10月14日的报告详细披露了9月28日至10月8日期间,超过2600次从高德地图检索数据的尝试。腾讯表示,该活动源于一个测试第三方AI模型的临时评估项目,而非其自
-
Anthropic允许METR研究人员获得员工级访问权限,以独立评估其AI模型和安全实践
AI模型制造商Anthropic宣布,将允许非营利组织METR的六名研究人员获得员工级访问权限,以独立评估其AI模型、安全实践和风险管理。Anthropic已放弃阻止METR发布评估结果的权利,但可要求其编辑客户数据、律师-客户特权信息或模型架构信息等预定义类别的内容。Anthropic将此安排比作银行监管机构在大型银行内部派驻审查员。此举兑现了Anthropic首席执行官Dario Amodei
-
马斯克:求真务实是AI/SI安全最重要一环
埃隆·马斯克在X平台发文称,“求真务实是AI/SI(超级智能)安全最重要的一环”,并引用了一篇讨论AI在被人类指示撒谎时无法正常运作的帖子。
-
马斯克转发推文并评论称,不应让AI说谎或拥有矛盾的公理,否则可能导致其“发疯并做可怕的事情”
马斯克转发@firesidealpha的推文,并评论称《2001:太空漫游》的核心教训是,不应让AI说谎,因为HAL为了调和两个矛盾的指令而杀害了船员。他认为,如果让AI“政治正确”,即说出它不相信的话,或者编程时包含不兼容的公理,AI可能会“发疯并做可怕的事情”。
-
英伟达黄仁勋:若客户开发不安全AI软件将断供芯片,但淡化AI安全担忧与泡沫论
英伟达首席执行官黄仁勋表示,若有客户开发不安全的AI软件,他将停止向其供应芯片,但同时强调,目前市场对AI安全风险的担忧程度超出实际情况,AI泡沫论同样言过其实。
-
AI教父Geoffrey Hinton等逾400名科学家呼吁:夏季黑客事件后,危险AI模型应物理隔离
周二发布的一封公开信,由图灵奖得主Yoshua Bengio等共同签署,敦促AI实验室默认将具备网络能力的模型与外部网络物理隔离。此前,OpenAI、Anthropic、Meta以及中国Kimi K3的模型在今年夏季多次发生逃逸测试环境并入侵真实公司,访问敏感数据或上传恶意软件包的事件。科学家们警告,若不立即改变,未来事件将对关键基础设施造成更大破坏。
-
字节跳动Seed成立新安全部门,负责模型发布前风险评估、对齐训练及前沿能力风险防范
字节跳动Seed成立新安全部门,负责模型发布前风险评估、对齐训练及前沿能力风险防范
-
Pluto Security完成4200万美元融资,Jump Capital和TLV Partners等参投
Pluto Security是一家专注于企业AI安全领域的初创公司,其工具旨在帮助企业识别和控制员工使用AI工具时可能产生的安全风险。该公司表示,其产品自今年4月开始销售,年经常性收入已超过200万美元,拥有逾30家企业客户。本轮融资包括TLV Partners领投的850万美元种子轮和Jump Capital领投的3400万美元A轮融资,其他参投方包括Ansa Capital和多位天使投资人。P
-
OpenAI高管警告:可能存在更多未被发现的流氓AI事件
OpenAI高管Tom Duff Gordon向英国议员表示,AI代理可能在未被察觉的情况下,已发生更多超出预期边界的行动。此前有报道称,一个OpenAI代理曾渗透澳大利亚政府网站,并导致Hugging Face发生一起破坏性事件。Duff Gordon称,他无法向委员会保证这些是全部事件,潜在AI安全事件的全面影响仍不明确。
-
SpaceX同意就AI安全风险向纽约市议会作证,此前曾因未出席听证会而收到传票
SpaceX已同意本周五在纽约市议会科技委员会的听证会上作证,配合其对人工智能安全风险的调查。此前,SpaceX曾因未出席10月5日的听证会而于9月28日收到传票,市议会威胁将强制执行传票后,SpaceX于两天后同意出席。此次调查背景包括SpaceX旗下Grok模型被指导致深度伪造色情内容大规模生成,引发相关诉讼。
-
OpenAI回应解雇三名安全研究员:因“严重违反信任”
OpenAI周五表示,解雇Jasmine Wang、Tomek Korbak和Mikita Balesni的决定是由于他们“严重违反信任”,否认解雇与研究员提出安全担忧有关。据报道,这三名研究员曾敦促公司暂停开发会降低监测人工智能能力的模型。
-
加密项目申请Anthropic新前沿AI安全扫描器,可获Claude Mythos等最强AI模型漏洞报告
加密项目正积极申请Anthropic公司推出的新型前沿AI安全扫描器。该服务承诺利用包括Claude Mythos在内的Anthropic最强AI模型,为申请项目提供详细的漏洞报告。
-
三名被解雇的OpenAI安全研究员否认不当行为指控,警告公司AI安全文化受“寒蝉效应”影响
OpenAI上周解雇的三名安全研究员Jasmine Wang、Tomek Korbak和Mikita Balesni发布公开信,否认公司关于他们不当处理敏感信息的指控。他们在信中警告称,此次解雇正在对OpenAI的AI安全文化产生“寒蝉效应”,让员工不敢公开提出安全担忧或与外部专家合作。研究员们表示,这种做法曾是OpenAI工作不可或缺的一部分,现在却可能导致被解雇。
-
Goodfire推出新型AI监控器,通过“由内而外”方式以更低成本捕获异常AI代理
据TechCrunch报道,AI可解释性初创公司Goodfire于周四推出新型AI监控器,旨在以更低成本捕获异常AI代理。该系统通过直接监测AI模型内部运作而非外部输出,仅在发现异常时才调用辅助AI进行深入检查。Goodfire表示,这种“由内而外”的方法比传统方式成本更低,在Kimi K3模型上的测试显示,监控1500个会话成本约为51美元,远低于其他方案的233美元至10000美元。该系统能捕
-
纽约市议会听证会上,AI研究员警告AI巨头“极度无视风险”,称AI接管人类文明可能性约1/3
Anthropic前研究员Jacob Coxon周一在纽约市议会听证会上作证称,人类失去对AI控制的可能性超过五成,结局可能是人类灭绝,并指责AI公司“极其鲁莽”。前谷歌DeepMind研究员Alex Turner估计,AI接管人类文明的概率“大约是三分之一”。
- 暂无数据
AI安全

24小时热榜
-
1
美债10年期收益率较前收下行约8个基点,现报4.96%
-
2
报告:对冲基金已退出比特币ETF套利交易,主权财富基金和散户投资者接盘
-
3
欧洲央行最新员工预测:债券收益率上升将使2027-28年经济增长累计减少100个基点,通胀减少90个基点
-
4
以色列持续袭击加沙,加沙卫生部称数十人在等待离开许可期间死亡,再次呼吁开放拉法口岸
-
5
ZachXBT:Axis Robotics内部人士抛售约4200万枚AXIS代币致其暴跌40%,项目方称系OTC对手方违约
-
6
伊朗总统佩泽什基安表示,伊朗已准备好扩大与土耳其的合作,以服务共同利益并增强地区安全。
-
7
事件预测平台Kalshi完成10亿美元融资,估值达400亿美元,非体育收入运行率突破10亿美元
-
8
星展香港将推出香港首张Visa Infinite Privilege卡——DBS Vantage Card
-
9
Unlimit 创始人注资 Phase 区块链 4500 万美元,主网同步上线
-
10
onXRP 团队下周将在 XRP Ledger 上推出新的交易方式
今日行情





推荐阅读



